Jevとは?テキストを書かない判断モデル(TypeSafe System One)【2026年】
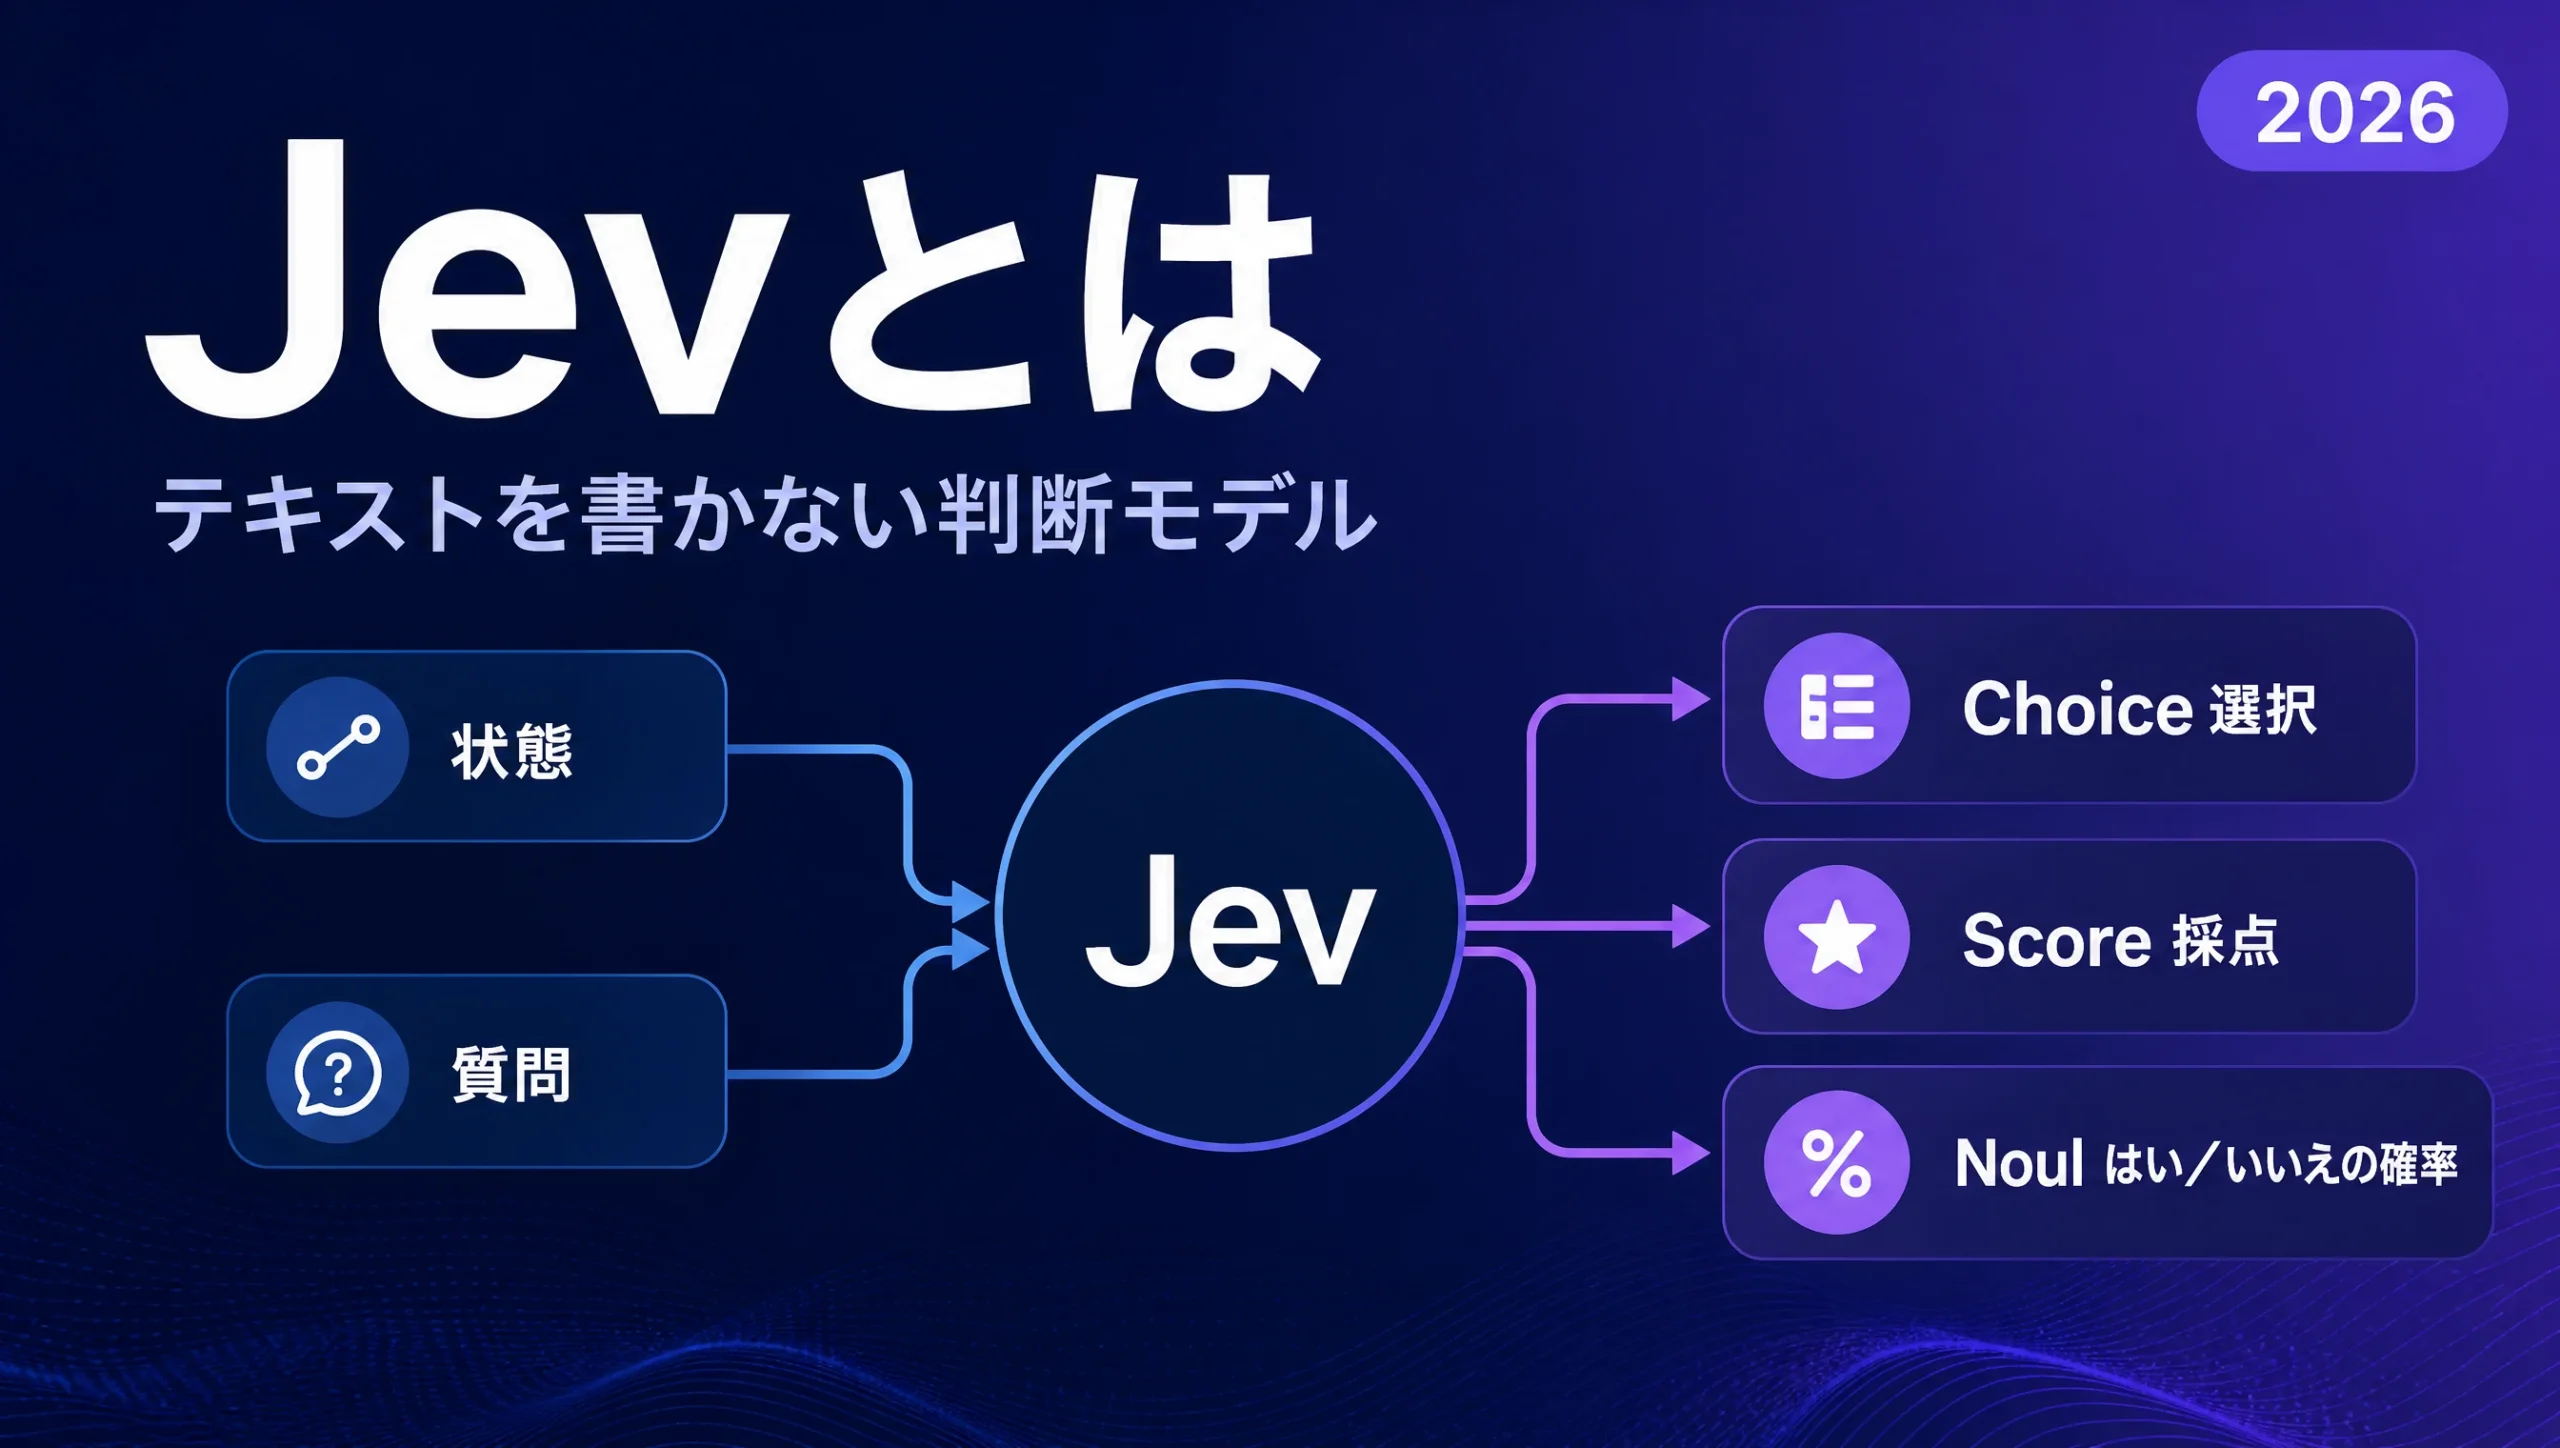
【結論】Jev(ジェフ)とは、TypeSafe AIが提供するSystem Oneモデルです。アプリケーションの状態と型付きの質問を受け取り、選択肢・スコア・はい/いいえの確率といった、コードがそのまま使える判断結果を返します。チャットの返答やコード生成は行いません。
- 質問の型は3つ。Choice(選択肢から選ぶ)、Score(段階評価)、Noul(はい/いいえの確率)
- 公式ドキュメントは、英語が主の学習言語で、日本語を含むCJKは同等の精度ではないと明記している。日本語の業務ログで使う前に、自社データでの確認が必要
- Claude CodeやCursorの「モデル差し替え」には使えない。コーディングエージェント本体はLLMのまま、アプリやエージェントの判断層として別途呼ぶ
2026年9月に公開され、エージェントのルーティングやガードレール向けの話題が広がっています。この記事では、AIエージェントや社内自動化を設計する担当者向けに、Jevの定義、LLMとの違い、導入前に決めることを整理します。
この記事でわかること
- Jev/System Oneの1文定義
- Choice・Score・Noulの違い
- LLMとの役割分担(置き換えではない理由)
- 企業で先に決めること(閾値・人への引き継ぎ・日本語精度)
- HITL・AI駆動開発との接続
Jevとは
Jevとは、TypeSafe AIのフラッグシップであるSystem Oneモデルです。状態(state)と型付きの質問(questions)を1回のリクエストで送り、型付きの答えと確率分布を受け取ります。公式の導入文は「非構造の状態を入れ、型付きの確率的判断が出る」と説明しています(出典:TypeSafe Docs「Introduction」)。
System Oneという呼び方は、カーネマンが整理した「速い判断(System 1)」と「遅い熟慮(System 2)」の対比に由来します。TypeSafeは、ソフトウェアが直接使える速い構造化判断のために、このクラスを定義しています(出典:TypeSafe Docs「System One」)。
読み方の定訳はまだ固まっていません。この記事では製品名どおり「Jev」と書き、初出で「ジェフ」と振ります。
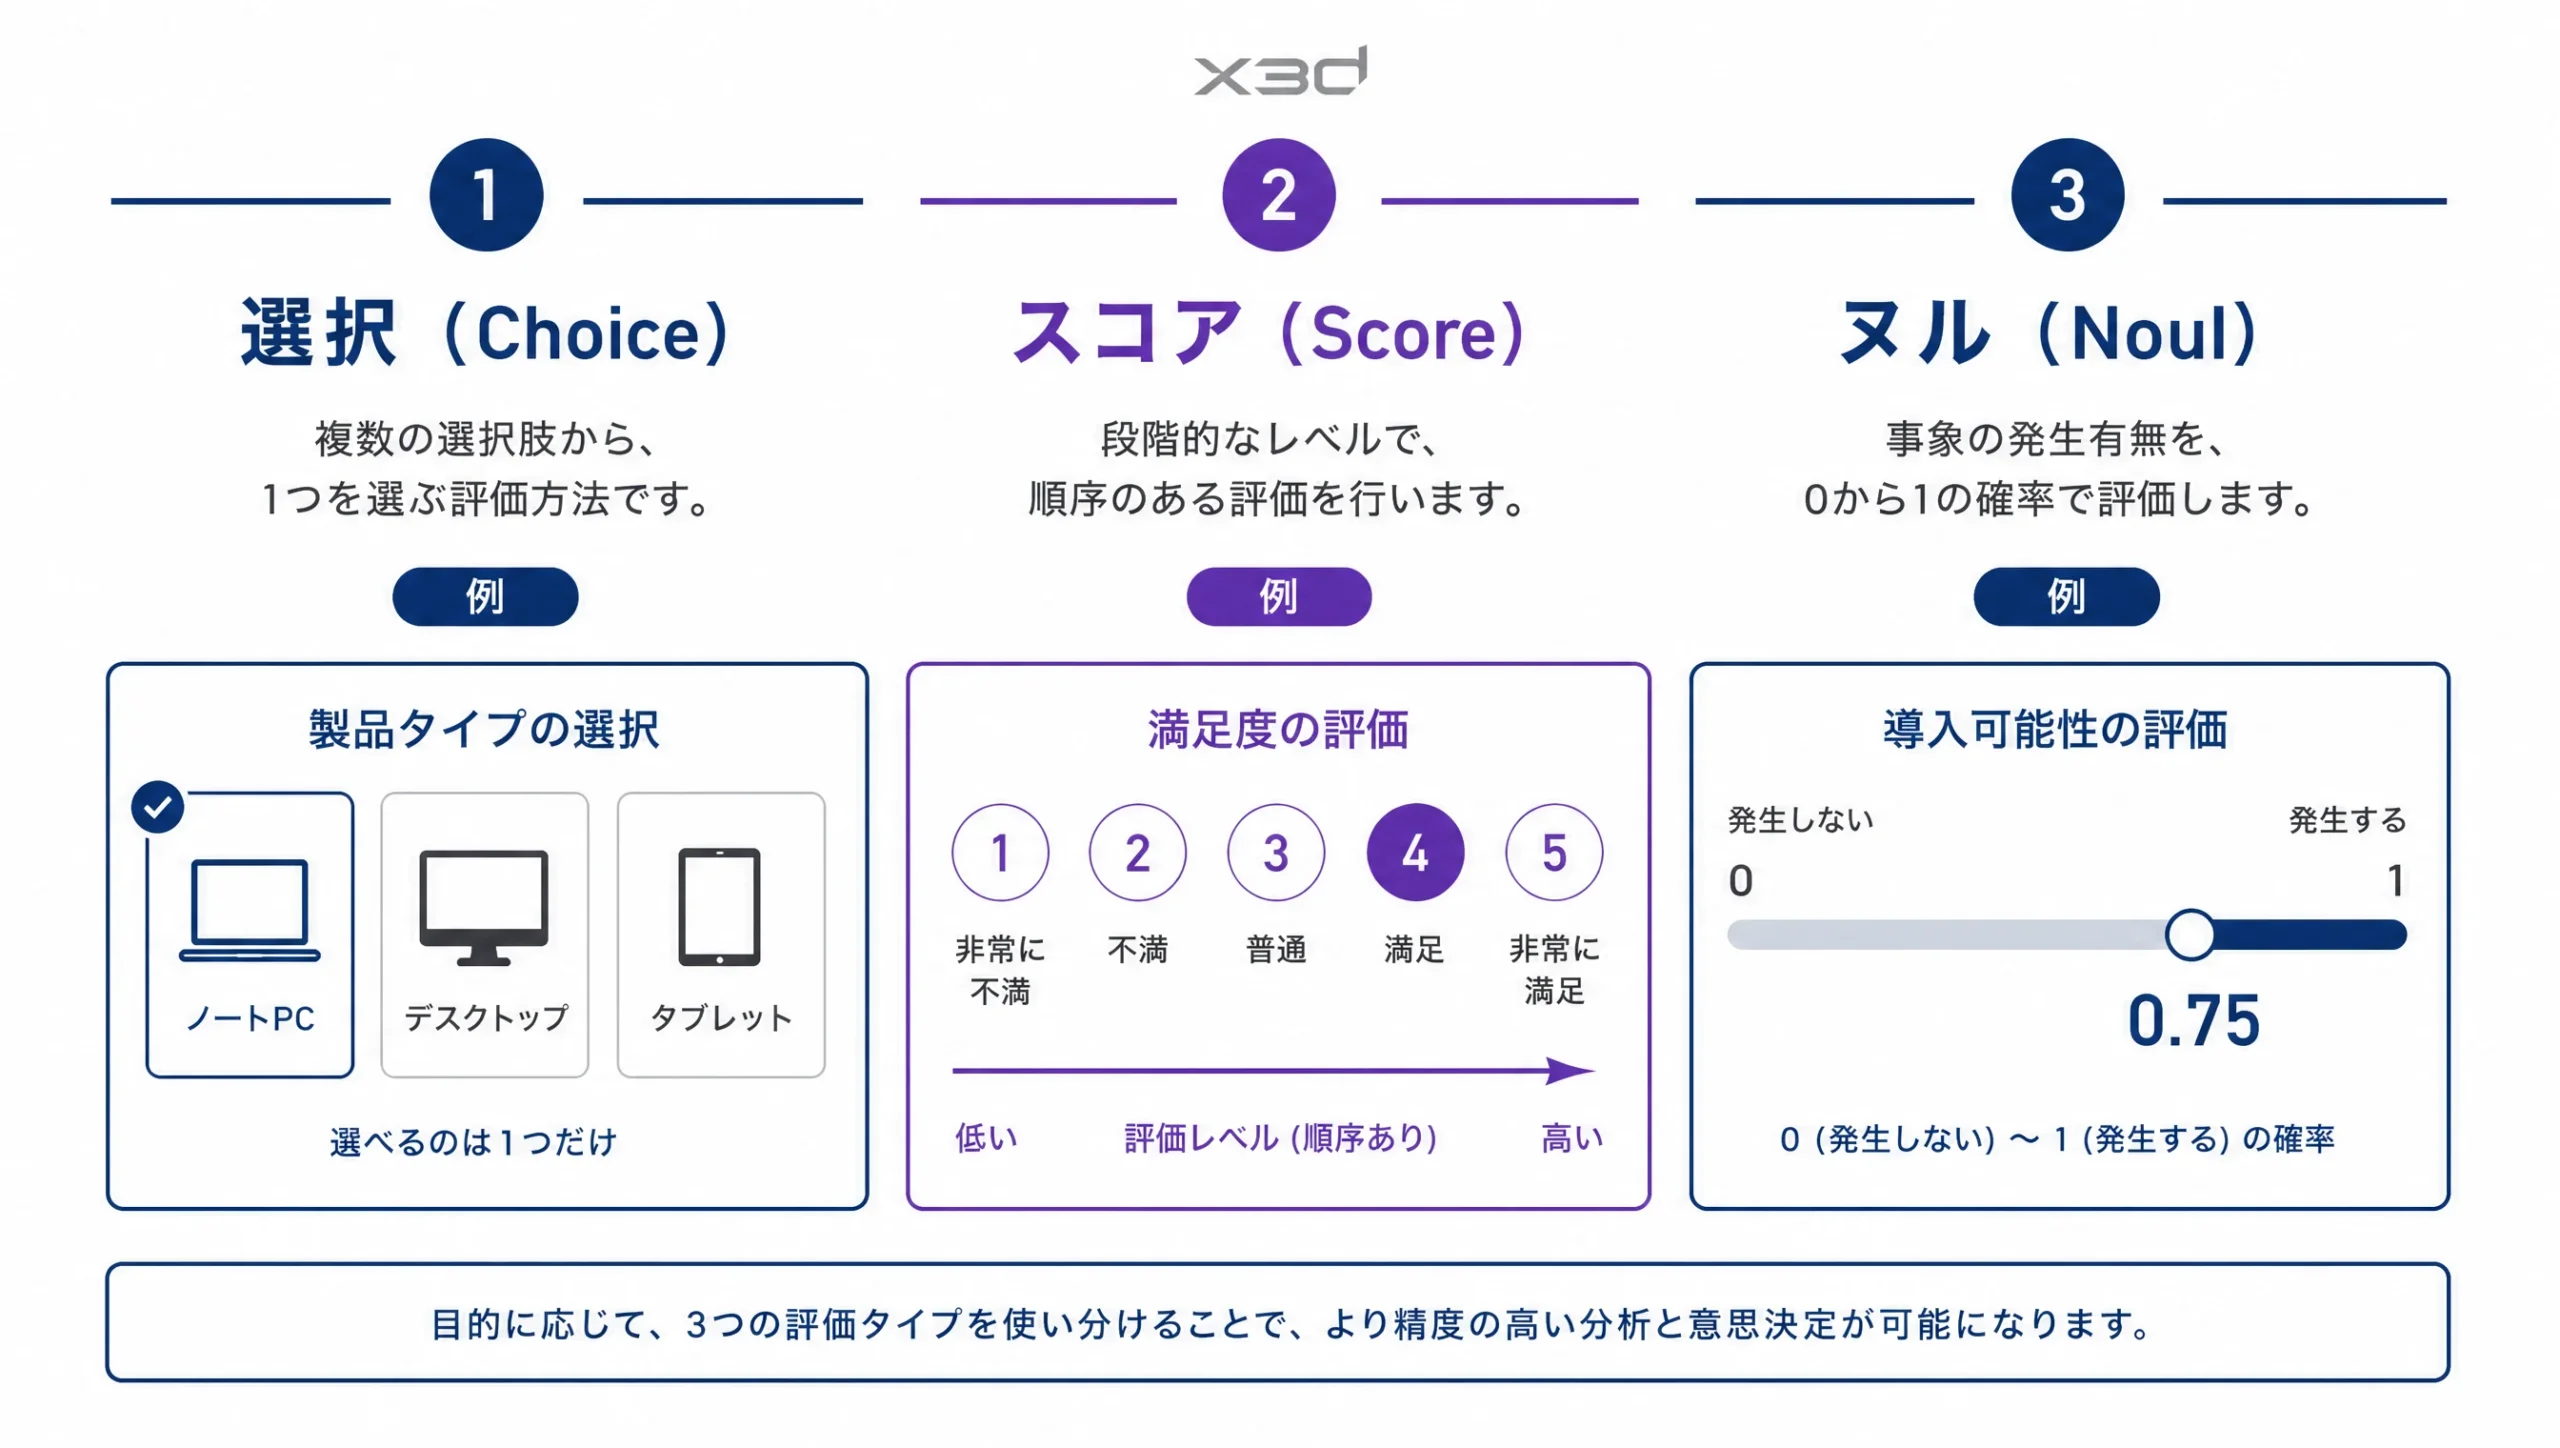
返す答えは3種類(Choice/Score/Noul)
TypeSafeは質問の型を3つに固定しています。同じ状態に対して複数質問を並べられ、公式には各質問が並列に評価されると説明されています(出典:同「Introduction」「Primitives」)。
| 型 | 何を聞くか | 返り値の要点 |
|---|---|---|
| Choice | 定義した選択肢から1つ選ぶ | 選択結果、各選択肢の確率、confidence |
| Score | 順序付きの段階で評価する | スコア(段階の間も取り得る)、分布、confidence |
| Noul | はい/いいえ(真偽)を聞く | 0〜1の確率(noul) |
広い問いを1本にまとめず、狭い問いを複数に分けてコード側で合成する設計が推奨されています。重みを変えるときはプロンプトを書き直すより、係数をコードで変える方が制御しやすい、というのが公式の立て付けです。
LLMとの違い(置き換えではない)
| LLM(例: コーディングエージェント本体) | Jev(System One) | |
|---|---|---|
| 主な出力 | 文章、コード、ツール呼び出しの説明 | 型付き判断と確率 |
| 向く仕事 | 設計、実装、長文の要約、対話 | 振り分け、採点、ゲート、閾値分岐 |
| コード側の扱い | 生成文を解釈・パースすることが多い | 返り値をそのまま分岐に使える |
| 公式の注意 | — | Claude Code/Cursor等のモデルIDとしては使えない |
TypeSafe自身が「Jev with coding agents」で次のように書いています。JevはコーディングエージェントのLLMを置き換えるものではない。エージェントはこれまでどおりLLMを使い、Jevを使うコードを書かせるか、自作アプリの判断層としてJevを呼ぶ(出典:TypeSafe Docs「Jev with coding agents」)。
料金の公式表(Jev 1.13)は、入力トークン100万あたり $0.042、出力トークンは無料です。コンテキストはリクエストあたり最大64kトークン、状態+最長の1質問は32kまで、と記載されています(出典:TypeSafe Docs「Models」、2026年9月25日確認)。ホスト型の別ゲートウェイでは単価が異なることがあるため、実契約の表を優先してください。
エージェントのどこに置くか
エージェントのループでは、毎ターンLLMに「次は何をするか」を文章で聞いていることが多いです。そのうち、行き先が有限で、確率と閾値で十分な判断は、Jev側に寄せられます。公式や二次解説でよく挙がるのは次です。
- 意図の振り分け:問い合わせを請求/障害/アカウントへ分ける
- モデルやハンドラの選択:軽い処理と重い処理で呼び先を変える
- ツール実行前のゲート:危険な操作かどうかを確率で見て、止める・確認する・通す
- confidenceに応じた人へのエスカレーション:確信度が低いときだけ人や大きいLLMへ回す
人が最終確認する設計は、Human in the Loop(HITL)とはの考え方と同じ線上にあります。Jevは「人が見る/見ない」の手前で、機械が扱う判断を狭く切る部品です。
企業で先に決めること
ニュースの速さだけで採用を決めると、あとから閾値と責任分界が崩れます。導入前に次を文書化します。
- どの判断をJevに渡し、どれをLLMや人に残すか(選択肢が閉じているか)
- 自動実行する確率・confidenceの閾値と、未達時の行き先(人/別モデル/保留)
- 日本語ログや社内用語での精度確認(公式は英語優先・CJKは同等ではないと明記)
- 本番ではバージョン固定か(
jev-latestは更新で挙動が変わり得る。閾値を合わせた版はID固定が公式の勧め) - 監査:どの状態と質問で、どの確率が出て、誰が最終承認したか
エージェント本体の作り方はAIエージェントの作り方、開発プロセス全体はAI駆動開発(AIDD)とはを参照してください。コーディングツール側の比較はClaude Code・Cursor・Codex比較にまとめています。
向くケース/向かないケース
| 向きやすい | 向きにくい |
|---|---|
| 有限の振り分け、Rubric採点、ツール実行の可否 | 長文の執筆、コード生成、対話そのもの |
| コードで閾値と合成ロジックを持てるチーム | 「全部チャットで決めたい」だけで設計する運用 |
| 英語中心の状態、または精度検証済みの日本語 | 未検証のまま日本語の複雑な社内文書だけを前提にする |
よくある質問
Q1. Jevとは何ですか?
TypeSafe AIのSystem Oneモデルです。状態と型付き質問を受け、Choice・Score・Noulなどの構造化判断を返します。テキスト生成は行いません。
Q2. ChatGPTやClaudeの代わりになりますか?
なりません。公式もコーディングエージェントのLLM差し替え用途ではないと書いています。文章生成や実装はLLM、狭い判断はJev、という分担です。
Q3. Choice・Score・Noulの違いは?
Choiceは定義した選択肢から選ぶ。Scoreは順序付き段階で採点する。Noulははい/いいえの確率(0〜1)を返します。
Q4. 料金はいくらですか?(2026年9月時点)
公式のJev 1.13表では、入力100万トークンあたり$0.042、出力は無料です。別ホスト経由は単価が異なることがあります。
Q5. 日本語で使えますか?
入力は自然言語テキストを受け付けます。ただし公式は英語が主で、CJKは同等ではないと明記しています。日本語業務では必ず自社データで試し、confidenceも見てください。
Q6. CursorやClaude Codeのモデル一覧に出せますか?
公式の案内では、エージェントのモデルIDとしてJevを選ぶ使い方ではありません。エージェントにTypeSafe連携のコードを書かせるか、アプリからAPIを呼びます。
Q7. 画像や音声は入れられますか?
現時点の公式仕様ではテキストのみです。画像・音声は先にテキストや構造化フィールドへ変換してからstateに載せます。
Q8. HITLとどう関係しますか?
Jevの確率やconfidenceが閾値を下回ったときだけ人に回す、という設計が典型です。人がループのどこに残るかはHITLの設計そのものです。
Q9. 193倍速い・445倍安いという数字は?
ベンダーや報道が示す比較数値です。条件依存で、公式のModelsページの価格表とは別物です。採用判断では自社ワークロードでの実測を優先してください。
まとめ
Jevは、文章を書くモデルではなく、ソフトウェアが分岐に使う判断を返すモデルです。LLMの隣に置き、振り分け・採点・ゲートを確率と閾値で切る。日本語は公式が同等ではないと書いているので、検証なしの全面採用は避けます。
エージェントの本番設計や内製化の相談は、AIエージェント導入支援・開発からどうぞ。
本記事は2026年9月時点のTypeSafe公式ドキュメント等の公開情報に基づいています。料金・仕様・言語性能は変更され得るため、最新は公式サイトをご確認ください。