Agentic RAGの評価設計|根拠らしさだけでは落ちる権限・鮮度・セッション【2026年9月】
【結論】Agentic RAGの評価設計とは、回答の見た目の正しさだけでなく、検索・鮮度・権限・セッション・ツール契約という層ごとに失敗を切り分けて測る仕組みを作ることです。
- 根拠への忠実性(Faithfulness)だけを見る評価では、古い文書や権限外の文書に忠実な誤答でも合格になり得る
- 2026年の複数の学術ベンチマーク(LayerRAG-Bench・AgenticRAGTracer)が、根拠評価だけの合格が実運用の失敗を見逃す偽陽性を報告している
- RAGASやTruLensなど既存の評価ツールは検索・生成の質を測る土台になるが、Agentic固有の失敗(サブクエリの迷走・権限漏れ)は別立てで見る必要がある
この記事では本番導入前の評価設計を担う開発責任者・情シス・PM向けに、2026年9月時点の公開情報に基づいて評価指標・チェックリスト・進め方を解説します。
なぜ「根拠らしさ」だけでは足りないか
Agentic RAGの評価とは、エージェントが検索・推論・回答生成を繰り返す過程で、どの段階で何が壊れたかを層ごとに特定する評価の設計方法です。RAG評価で広く使われるFaithfulnessは、回答内の主張が取得したコンテキストに支えられているかを見る指標です(出典:Ragas Faithfulness)。しかしAgentic RAGでは、取得そのものが古い・権限外・別セッションの文脈だと、「根拠には忠実だが業務的には誤り」という答えが残ります。
2026年7月に公開されたLayerRAG-Bench(arXiv:2607.27353)は、8業種・240タスク・9種類の障害シナリオ(証拠の陳腐化、ツール契約の不整合、権限拒否、セッション文脈の取り違えなど)を組み合わせ、9モデルで38,880件のタスクレベル記録を取得しました。スキーマ不整合はスキーマ正規化で成功率が0.000から0.913まで回復した一方、古い証拠・出力欠落・権限拒否・誤ったセッション文脈は同じ修正では回復せず、根拠らしさだけの評価では運用上の障害を大きく見逃す、と報告しています。障害の種類ごとに効く対策が違う、という点が実務上重要な発見です。
評価フレームワークの選び方
まず土台となる評価ツールの特徴を押さえます。いずれもLLM-as-a-judge方式で、人手のラベル付けなしに動かせる点が共通します。
| ツール | 中核の指標 | 向いている使い方 |
|---|---|---|
| RAGAS | Faithfulness/Answer Relevancy/Context Precision/Context Recall | Pythonで手早くRAG指標と合成テストデータを作る |
| TruLens | RAG Triad(Context Relevance/Groundedness/Answer Relevance) | トレースベースで検索・生成をひも付けて追う |
| DeepEval | RAG・エージェント・マルチターン・MCP・安全性まで50種類超 | Agentic固有の評価軸まで一つのライブラリでカバーしたい場合 |
ただし独立系の比較検証では、5つのツールいずれも「実体が正しい文脈」と「実体は一致するが答えが誤っている文脈」を区別できず、後者を高く評価してしまう共通の弱点が報告されています。つまりツールを導入しただけでは、業務的に誤った根拠を見抜けません。層別のチェックリストを人手で併用する理由がここにあります。
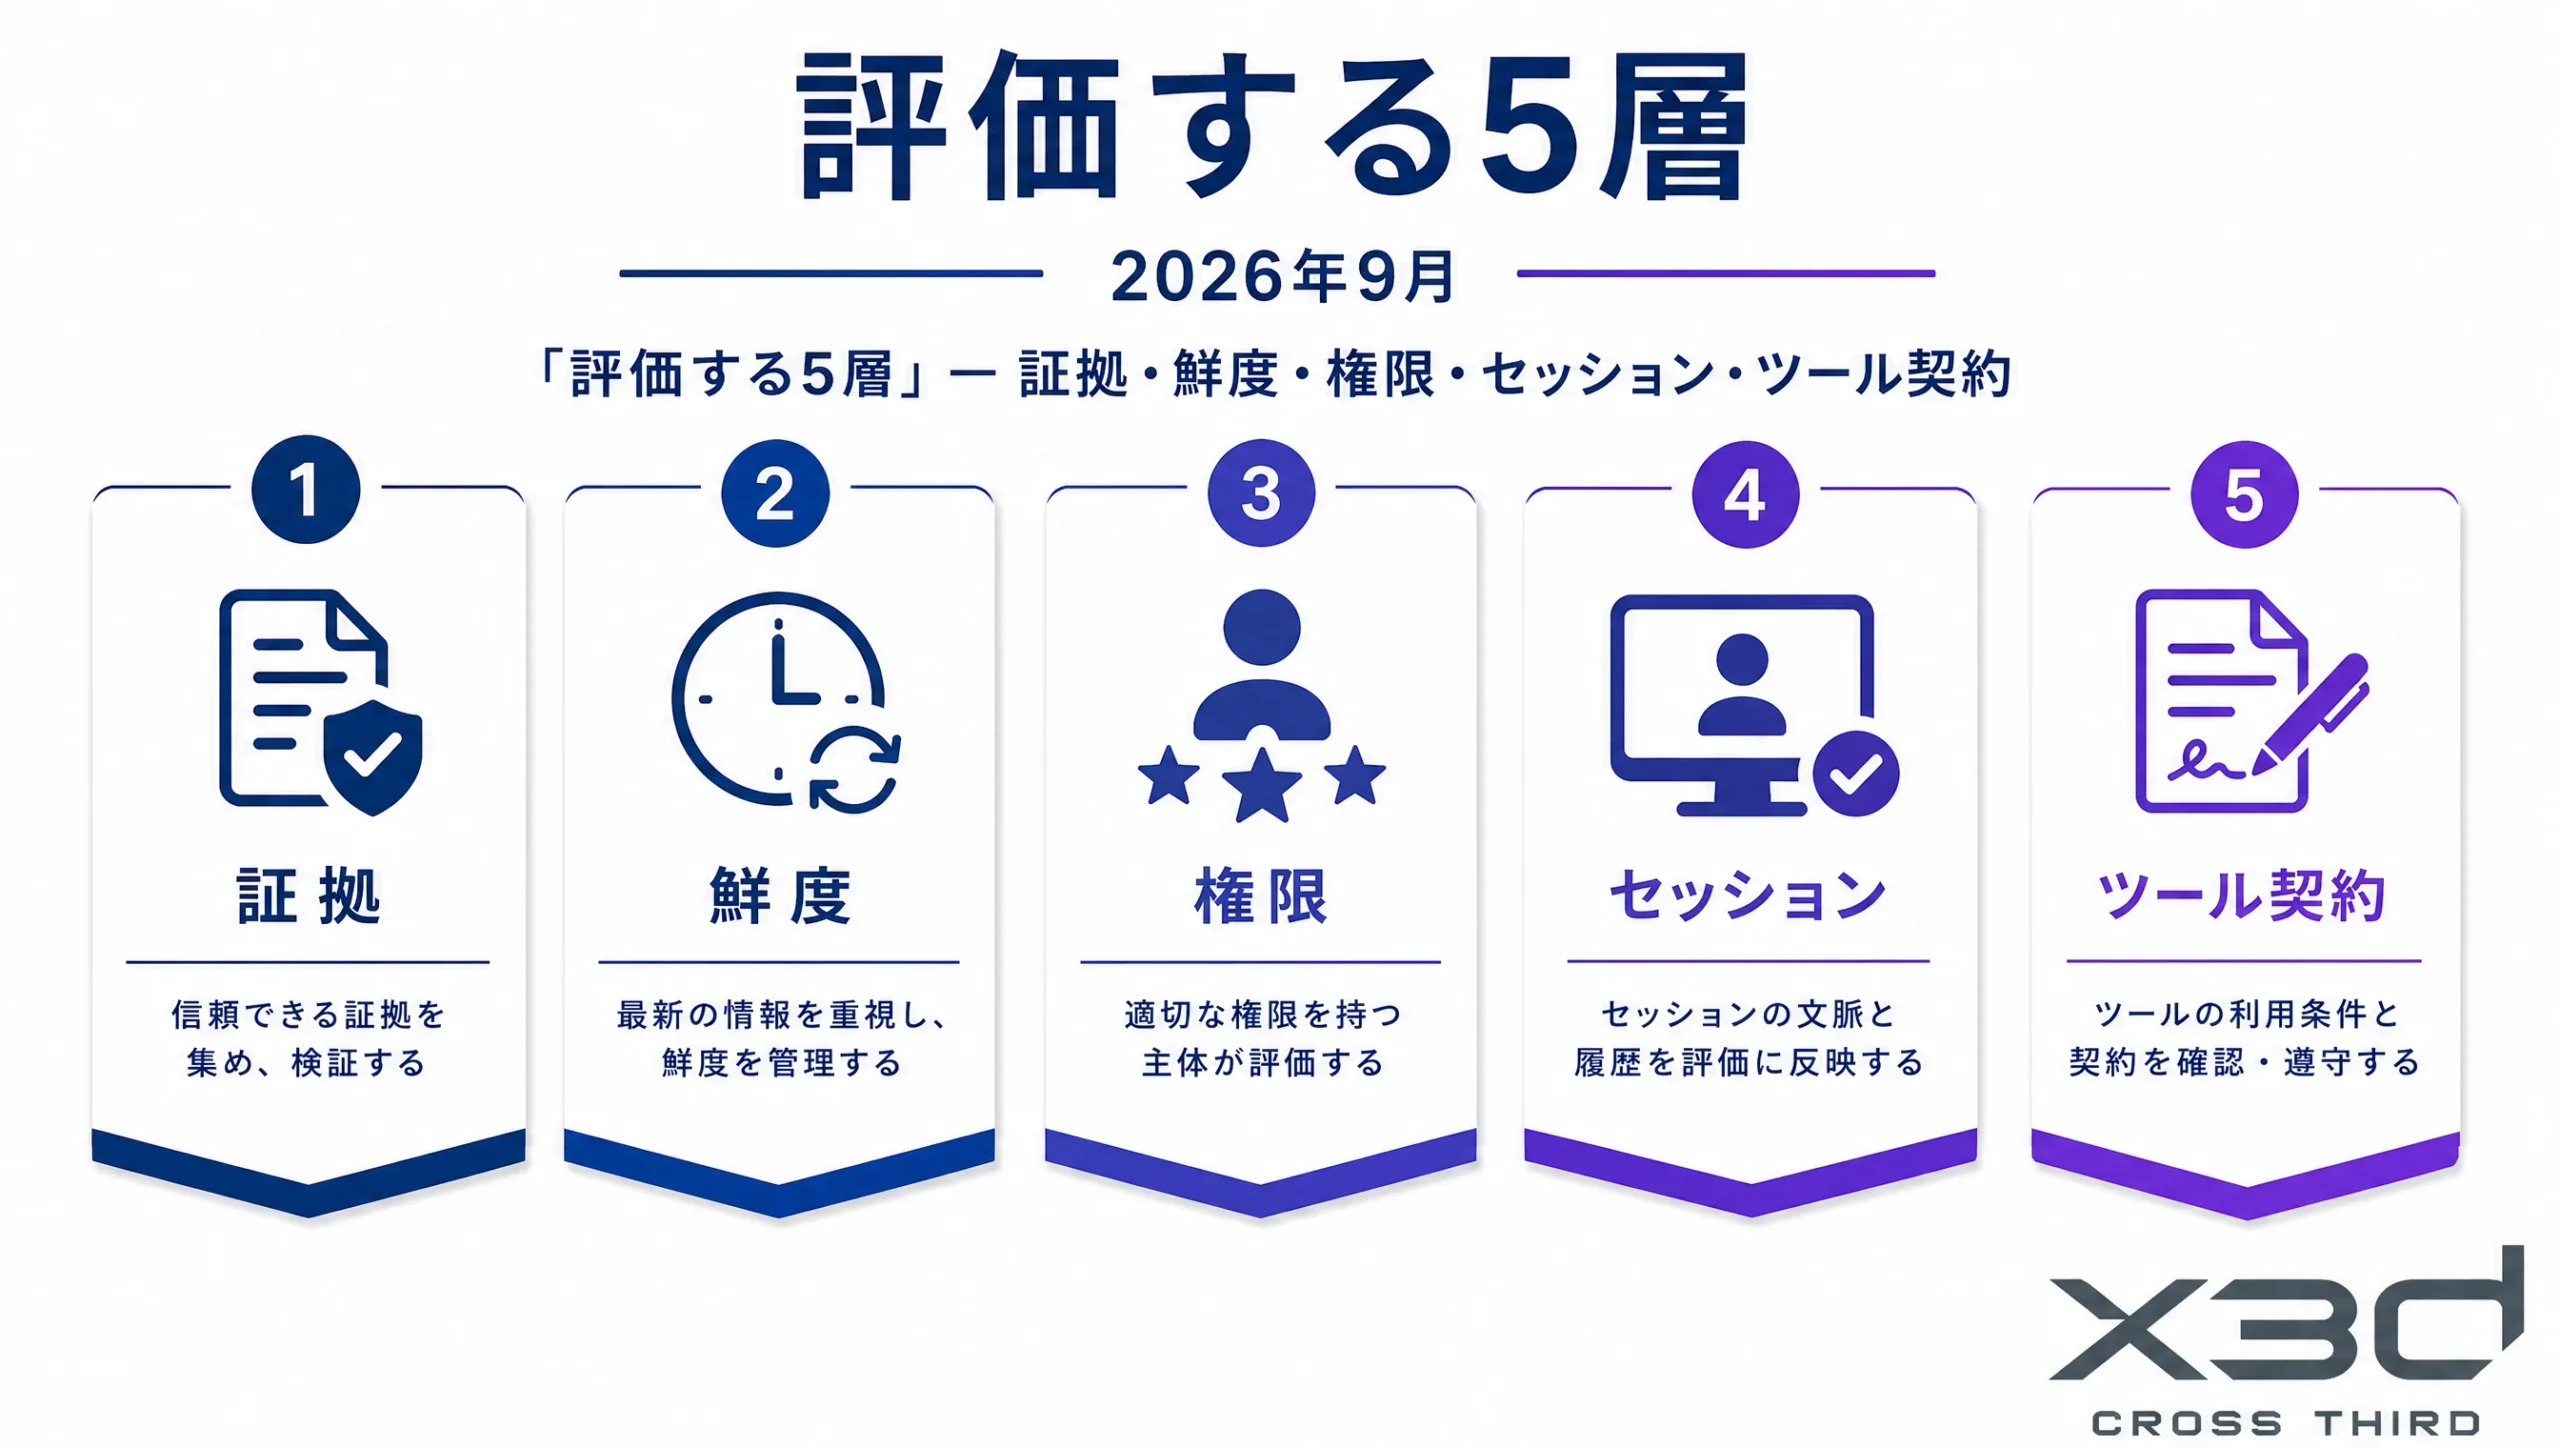
測る層のチェックリスト
Agentic RAGの評価では、下表の5層それぞれに症状と検出方法を用意します。1つの指標に集約しないことが重要です。
| 層 | 見るもの | 落ちたときの症状 |
|---|---|---|
| 証拠(evidence) | 正しい文書・正しい箇所が取れているか | それらしいが的外れな根拠を提示する |
| 鮮度 | 版・日付が業務要件を満たすか | 旧規程や旧料金を根拠に正解扱いになる |
| 権限 | そのユーザー/エージェントが見てよい情報か | 機密情報の漏洩、または過剰な拒否 |
| セッション | 会話文脈の取り違えがないか | 前の案件や別ユーザーの前提が混ざる |
| ツール契約 | MCP/APIの入出力仕様が期待どおりか | ツール呼び出しの失敗を無視して回答を続ける |
検索側の指標(Context Precision/Context Recall)で取りこぼしやノイズを見て、生成側の指標(Faithfulness/Answer Relevancy)で根拠忠実性と応答の質を見る、という2系統に分けると原因の特定が早くなります。Agentic固有では、サブクエリの発行数・参照ソースの分散・失敗時の再試行回数といった運用指標も加えます。
Agentic固有の失敗パターンとベンチマーク
2026年3月公開のSoK論文(arXiv:2603.07379)は、Agentic RAGを有限ホライズンの部分観測マルコフ決定過程として整理し、計画・記憶・ツール呼び出し・検索戦略の軸で分類しました。この論文は、静的な一問一答評価では見えないリスクとして、誤りが連鎖する幻覚の伝播、記憶の汚染、検索のミスアラインメント、ツール実行の連鎖的な脆弱性を挙げています。単発の正答率だけでなく、途中の判断の軌道(trajectory)も評価対象に含めるべきだという指摘です。
2026年に公開されたAgenticRAGTracer(arXiv:2602.19127)は、多段階の検索推論を「どのホップで失敗したか」まで追える1,305件のベンチマークを構築しました。最高性能のLLMでも、4ホップの難問では正解率が22.6%に落ち込み、失敗の主因は推論の連鎖が早期に途切れる、または逆に必要以上に広がりすぎる「配分ミス」だったと報告しています。自社の評価セットにも、単一ホップだけでなく多段階の質問を混ぜる価値がここにあります。
評価セットに何を入れるか
- 本番に近い実問(過去の問い合わせログから抽出)
- 意図的に古くした旧版文書を根拠に含む質問(鮮度テスト)
- 権限境界をまたぐ質問(過剰開示・過剰拒否の両方を確認)
- 会話が続いた状態での言い換え質問(セッション取り違えの確認)
- ツール呼び出しが失敗するケース(タイムアウト・空応答)
評価運用の進め方
| 順 | 内容 |
|---|---|
| 1 | 本番想定の問いを50〜100件収集し、5層それぞれに該当する障害ケースを混ぜる |
| 2 | RAGAS/TruLens等で検索側・生成側の基礎指標を自動計測する |
| 3 | 層別チェックリストを人手でレビューし、機械評価が拾えない誤りを洗い出す |
| 4 | 誤答コストが高い操作(外部送信・契約・権限変更)の前にHITL(人の承認)を置く |
| 5 | 単一クエリで解けない質問が残る領域だけAgentic経路に載せ、再評価する |
RAGの構築手順そのものはRAG構築の進め方(5ステップ)、Microsoft環境でのAgentic RAG構築はMicrosoft Copilot環境でAgentic RAGを構築する、承認フローの設計はMCPガバナンスとはを参照してください。評価と運用を担う人材育成はエンジニア・PM育成研修で支援しています。
よくある質問(FAQ)
Q1. Agentic RAGの評価設計とは何ですか?
検索・鮮度・権限・セッション・ツール契約の5層それぞれで失敗を切り分けて測る評価の作り方です。単一指標に頼らないのが要点です。
Q2. Faithfulnessだけでよいですか?
いいえ。古い文書や権限外のコンテキストに忠実な誤答があり得ます。層別のチェックリストと併用してください。
Q3. 評価セットに何を入れますか?
本番に近い実問、旧版文書、権限境界をまたぐ質問、会話の続き、ツール失敗ケースの5種類です。
Q4. RAGASやTruLensは使えますか?
使えます。FaithfulnessやAnswer Relevancyは参照データなしで回しやすい指標です。ただし層別チェックは別途人手で用意します。
Q5. Agentic固有で追加すべき観測は何ですか?
サブクエリの発行数、参照ソースの分散、activityログ、レイテンシとトークン消費量です。多段階の推論が途中で途切れていないかも確認します。
Q6. HITL(人の承認)はどこに置きますか?
誤答コストが高い操作の直前に置きます。外部送信、契約関連、権限変更などが代表例です。
Q7. いつからAgentic経路を評価対象に含めますか?
単一クエリで解けない質問が業務上残った段階です。最初から全問をAgenticにすると、評価も運用も複雑になります。
Q8. 学術ベンチマークの数値はそのまま自社に当てはまりますか?
当てはまりません。LayerRAG-BenchやAgenticRAGTracerはベンチマーク用の環境で測った数値です。自社の文書・業務フローで同様の障害シナリオを再現し、自社データで測定してください。
Q9. x3dに相談できますか?
できます。武石幸之助は2017年から対面で1,800社超・受講者5,000名超にAI導入支援を実施しています(認定講師分・オンラインは含まない)。評価設計から運用体制の構築まで支援します。
参考文献・出典
- Ragas Faithfulness(公式ドキュメント)
- LayerRAG-Bench: A Cross-Layer Reliability Benchmark for Agentic RAG (arXiv:2607.27353)
- SoK: Agentic Retrieval-Augmented Generation (RAG) (arXiv:2603.07379)
- AgenticRAGTracer: A Hop-Aware Benchmark for Diagnosing Multi-Step Retrieval Reasoning in Agentic RAG (arXiv:2602.19127)
本記事は2026年9月時点の公開情報に基づいています。評価ツールの機能・ベンチマークの数値は更新が速いため、最新は各公式ドキュメント・論文をご確認ください。
x3d株式会社では、本記事で解説したAgentic RAGの評価設計・本番運用に関する企業研修・導入支援・システム開発を提供しています。
まずはお気軽にご相談ください。